Daten sind die Ressource der Gegenwart. Und dies gilt nicht nur für die Forschung. Digitalisierung ist für Unternehmen aller Branchen und jeder Größe eine strategische Frage. Interdisziplinäres Wissen zur Digitalisierung und eine grundlegende Informationskompetenz für die digitale Arbeitswelt, für Maschinelles Lernen und für Anwendungen von Künstlicher Intelligenz werden in Zukunft noch stärker auf vielen Ebenen von Bedeutung sein.
In den Veranstaltungen des Studium-Generale-Zertifikats „Data Literacy“ erhalten Studierende Kenntnisse zu den wichtigsten Aspekten der Datensammlung, -nutzung und -analyse.
Hauptziel ist es, für alle Studierende am KIT die Möglichkeit zu bieten, ein Grundverständnis dafür zu entwickeln, wie Daten gesammelt, bearbeitet, verwaltet, ausgewertet und angewendet werden. Auf diesem Wissen bauen Fähigkeiten auf, die es ermöglichen, evidenzbasiert Entscheidungen zu treffen, was zunehmend in allen wissensbasierten Branchen und Berufen benötigt wird.
Das Zertifikat umfasst die Ringvorlesung Data Literacy, in der KIT-interne und -externe Expertinnen und Experten grundlegende Fragestellungen der Datenkompetenz behandeln, sowie zwei weitere Seminare aus dem Themenfeld.
Art und Umfang der Studienleistungen
Ringvorlesung + 2 Seminare
8 LP
Leistungsnachweise: ein unbenoteter Teilnahmeschein in der Ringvorlesung (Anwesenheit und Lernprotokoll, 2 LP); zwei benotete Leistungsnachweise, die entweder über ein Kurzreferat oder eine schriftliche Arbeit erbracht werden (jeweils 3 LP)
Die Elemente des Zertifikats können in einer beliebigen Reihenfolge absolviert werden, so lange eine Einschreibung beim KIT als Studierende/r oder Promovierende/r vorliegt.
Für eine Teilnahme an den Zertifikaten am FORUM ist eine schriftliche Anmeldung erforderlich. Das Anmeldeformular können Sie Anmeldeformular können Sie hier herunterladen, ausfüllen, abspeichern und an stg∂forum.kit.edu senden. Alternativ können Sie das ausgefüllte Formular auch im Sekretariat des FORUM abgeben.
Die Anmeldung ist jederzeit möglich. Falls Sie das Zertifikat doch nicht vollständig absolvieren können, hat das keine Konsequenzen. Geben Sie uns in diesem Fall bitte kurz Bescheid an stg∂forum.kit.edu.
Interdisziplinäres Wissen zur Digitalisierung und eine grundlegende Informationskompetenz für die digitale Arbeitswelt, für maschinelles Lernen und für Anwendungen von Künstlicher Intelligenz sind sowohl im Alltag als auch im Studium und Berufsleben von großer Bedeutung.
Die Ringvorlesung Data Literacy unterstützt Studierende aller Fächer dabei, ihre Datenkompetenz zu erweitern. Durch interdisziplinäre Vorträge und Diskussionen wird ein Grundverständnis dafür entwickelt, wie Daten gesammelt, bearbeitet, verwaltet, ausgewertet und angewendet werden.
In wechselnden Vorträgen geben KIT-interne und -externe Expertinnen und Experten Einblicke in Forschung und Wissenschaft – stets begleitet von einem Blick auf die Risiken und gesellschaftlichen Implikationen.
Nach jedem Fachvortrag wird Raum für Diskussion eröffnet und die Zuhörenden kommen mit den Expertinnen und Experten ins Gespräch.
Für die Teilnahme ist kein thematisches Vorwissen erforderlich. Studierende und Promovierende aller Fachrichtungen sind eingeladen, ebenso wie KIT-Mitarbeitende und zugelassene Gasthörende.
Einzelne Vorträge mit Diskussion finden auf Englisch statt.
Gasthörende sind in der Ringvorlesung herzlich willkommen. Um teilnehmen zu können, ist 1) die erfolgte Zulassung als Gasthörende/r und 2) eine Anmeldung zur Ringvorlesung erforderlich.
Voraussetzung: Sie haben sich bis zum 31. Oktober 2026 als Gasthörende/r am KIT registriert (inkl. Semestergebühr etc.).
Bitte melden Sie sich anschließend für den Besuch der gesamten Ringvorlesung hier an: Anmeldung über SignMeUp (ggf. bitte zunächst als Externe/r Nutzer/in für das Portal registrieren).
Mehr Informationen für Gasthörende finden Sie auf folgender Seite des FORUM.
Registration for guest auditors
Guest auditors are warmly welcome to attend the lecture series. To participate, you must 1) be admitted as a guest auditor and 2) register for the lecture series.
Requirement: You must have registered as a guest auditor at KIT by October 31, 2026 (including semester fee, etc.).
Please register afterwards for the lecture series here: Registration via SignMeUp (if necessary, please register first as an external user for the portal).
Further information for guest auditors can be found here (in German) or here (in English).
Anmeldung für Einzeltermine
Studierende, Promovierende, Mitarbeitende und registrierte Gasthörende am KIT können vorbehaltlich freier Plätze auch nur an Einzelterminen der Ringvorlesung teilnehmen.
Melden Sie sich in diesem Fall bitte per E-Mail an dataliteracy∂forum.kit.edufür die entsprechenden Termine an.
Registration for individual sessions
Students, doctoral candidates, KIT employees, and admitted guest auditors at KIT may attend individual sessions of the lecture series, subject to availability.
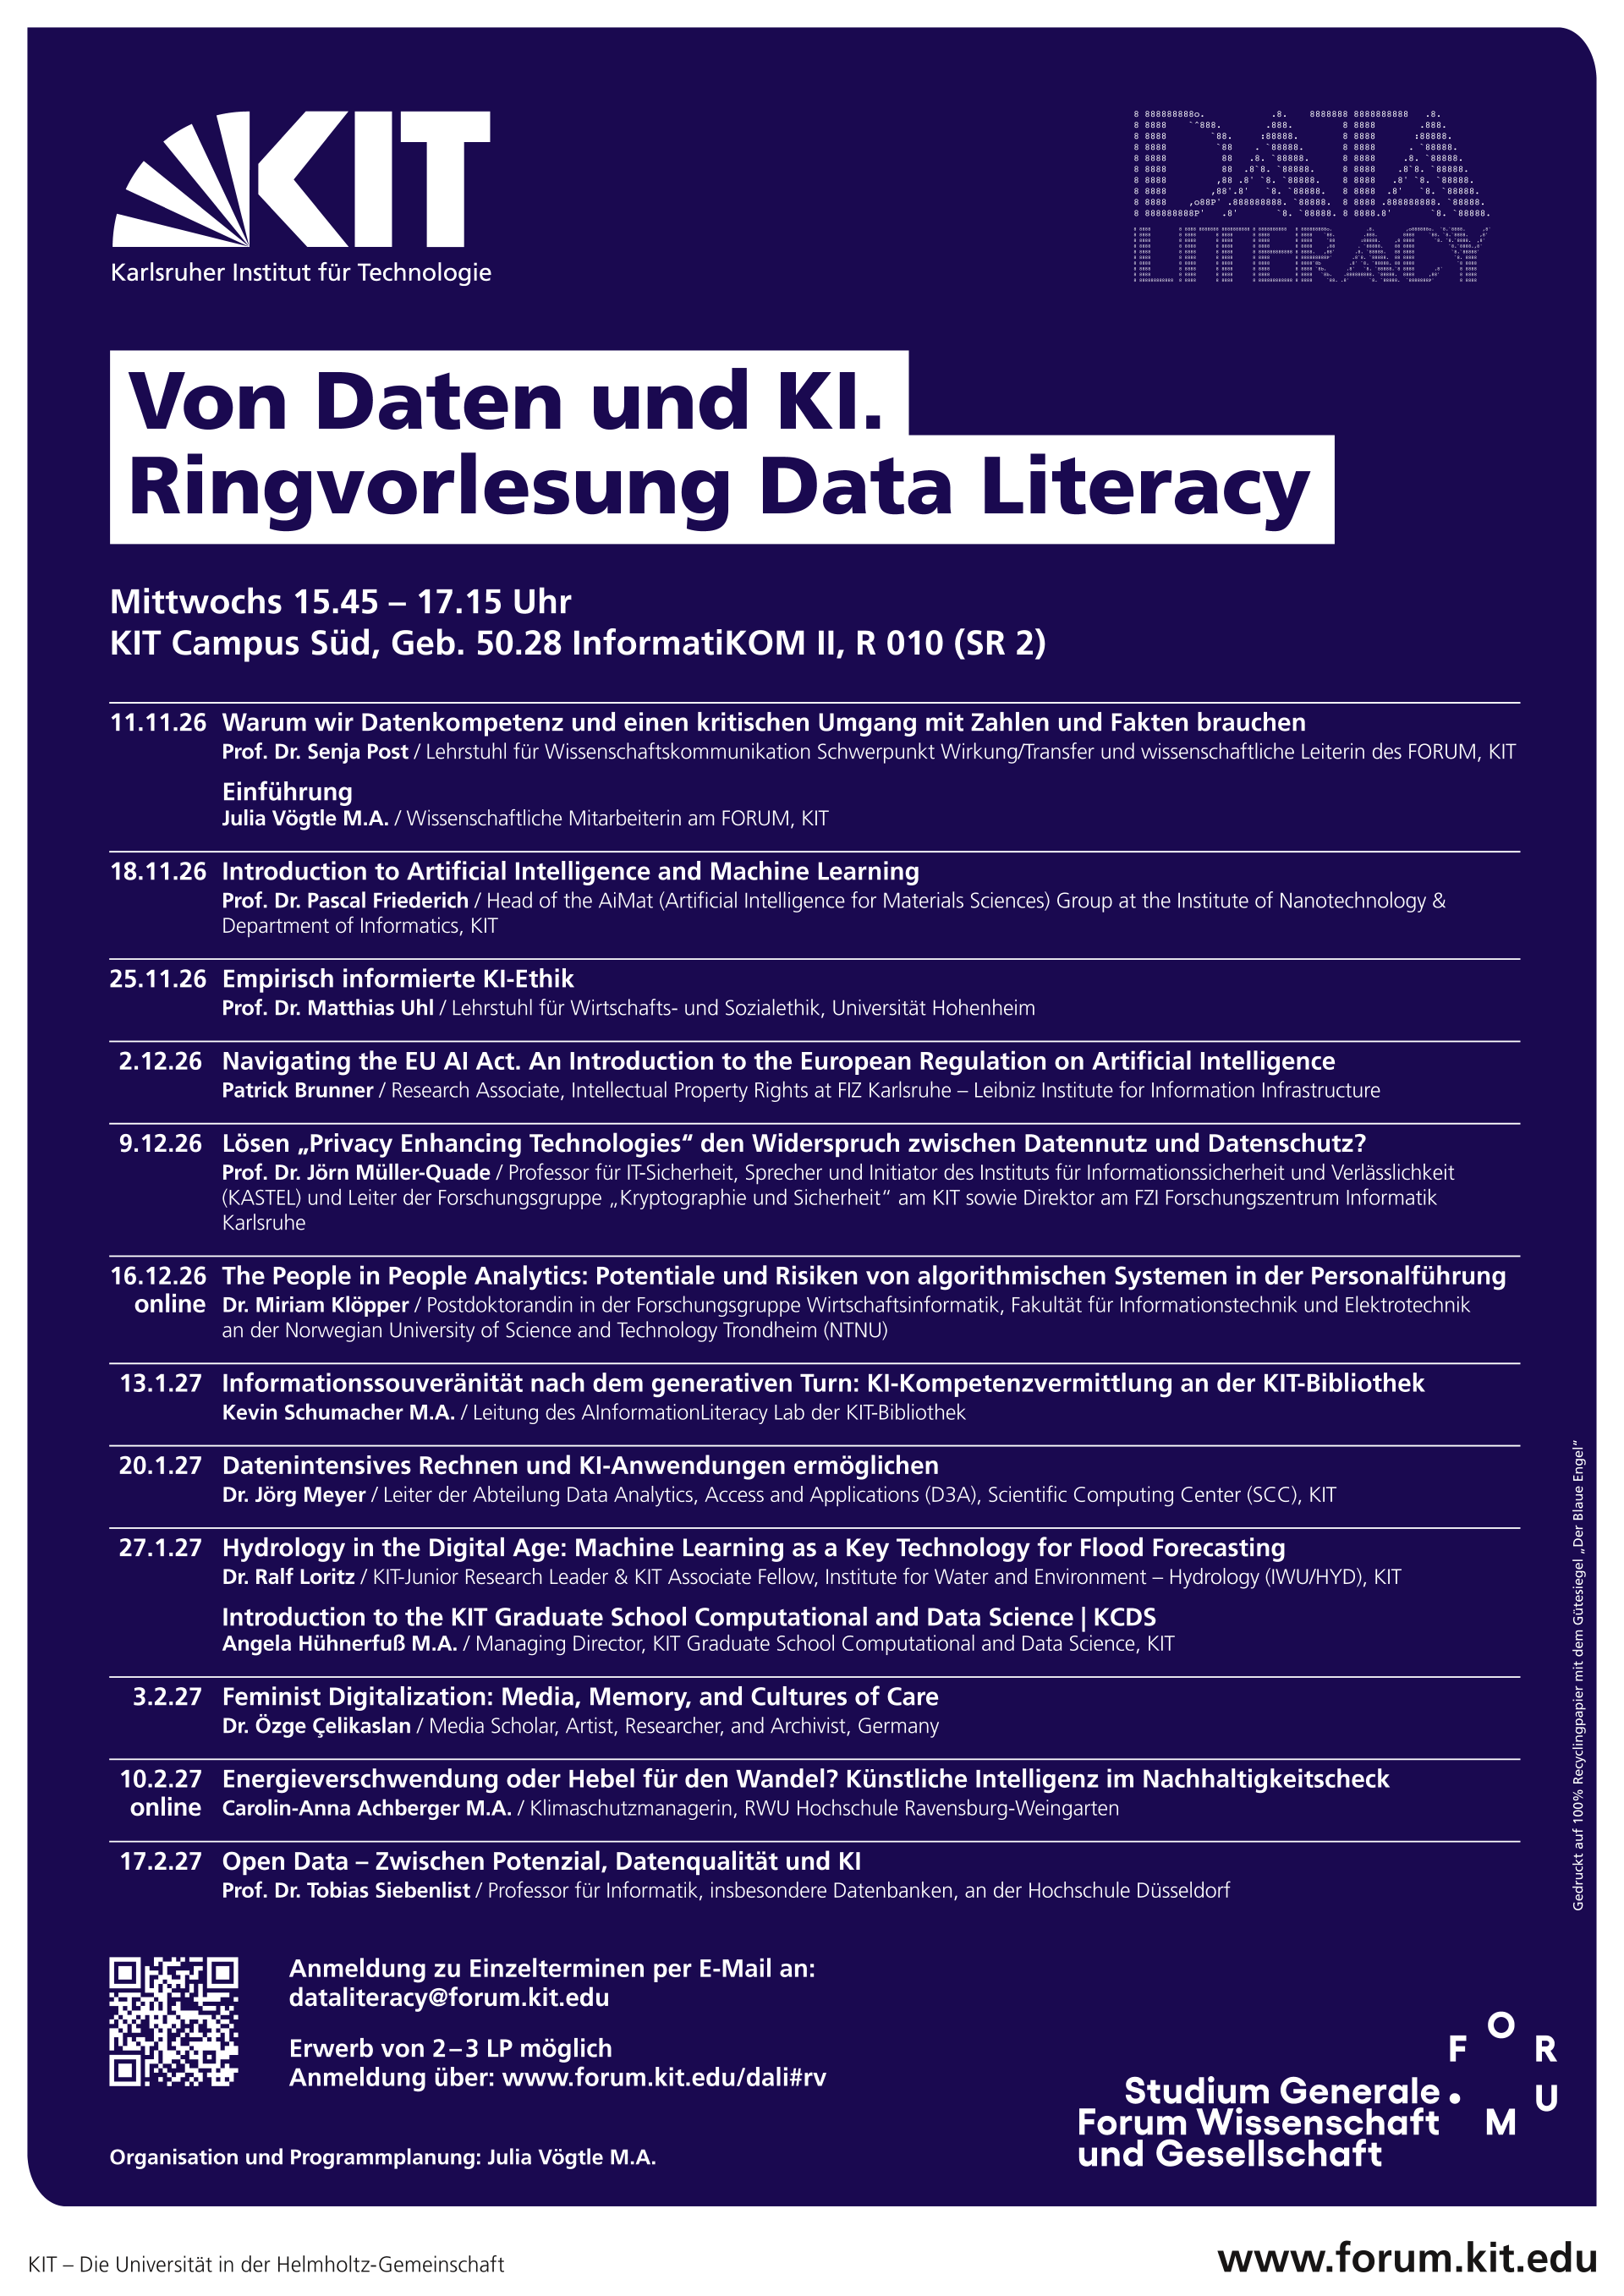
Warum wir Datenkompetenz und einen kritischen Umgang mit Zahlen und Fakten brauchen
Einführung
Julia Vögtle M.A. Wissenschaftliche Mitarbeiterin am FORUM, KIT
Vortrag
Prof. Dr. Senja Post Lehrstuhl für Wissenschaftskommunikation mit Schwerpunkt Wirkung / Transfer und wissenschaftliche Leiterin des FORUM, KIT
Datenkompetenz ist als Schlüsselkompetenz des 21. Jahrhunderts von zunehmender Relevanz in der Berufs- und Alltagswelt. Der Eröffnungsvortrag der Ringvorlesung führt mit einem kritischen Blick auf den grundlegenden Umgang mit Zahlen und Statistiken in die Vorlesungsreihe ein und bildet somit die Basis für die nachfolgenden Vorträge.
Zahlen und Statistiken sind Mittel der Wissenschaft und Medienberichterstattung, komplexe Sachverhalte und übergreifende Zusammenhänge präzise und komprimiert darzustellen. Allerdings werden Zahlen und Statistiken in gesellschaftlichen Debatten häufig irreführend verwendet – sie werden überschätzt, unterschätzt, missverstanden oder zugunsten exemplarischer Fallbeispiele vermieden.
Der Vortrag gibt, basierend auf empirischen Studien, einen Überblick über häufige Muster der Verwendung und Darstellung von Zahlen und Statistiken in öffentlichen Debatten und diskutiert ihre potenziellen Wirkungen auf die Vorstellungen der Menschen.
Mittwoch, 18. November 2026, 15.45 Uhr
Introduction to Artificial Intelligence and Machine Learning
Prof. Dr. Pascal Friederich
Head of the AiMat (Artificial Intelligence for Materials Sciences) Group at the Institute of Nanotechnology & Department of Informatics, KIT
The lecture begins with a general introduction to the concepts of artificial intelligence (AI) and machine learning (ML) from a computer science perspective, followed by a brief historical overview. To provide a basic understanding of the technologies and methods, an overview of AI/ML developments and breakthroughs in recent years follows, including the technical basics explained in an intuitive and accessible manner: neural networks, transformers, and generative AI. The lecture concludes with a discussion of several critical aspects of AI – in particular, bias in AI systems, resource and energy consumption, and societal impacts – as well as a (non-exhaustive) overview of AI/ML research activities at KIT, primarily from a computer science perspective.
Mittwoch, 25. November 2026, 15.45 Uhr
Empirisch informierte KI-Ethik
Prof. Dr. Matthias Uhl
Lehrstuhl für Wirtschafts- und Sozialethik, Universität Hohenheim
Der Vortrag gibt einen Überblick über ausgewählte aktuelle Fragen der KI-Ethik und beleuchtet den Beitrag, den empirische sozialwissenschaftliche Forschung zu ihrer Bearbeitung leisten kann. Es werden die Themenfelder der Maschinenethik und der Ethik der Mensch-Maschine-Interaktion angesprochen. Die Maschinenethik betrachtet KI als moralischen Agenten und reflektiert, welche Prinzipien dessen „Handeln“ leiten sollten. Im Vortrag werden hier beispielhaft Pflegeroboter und autonome Fahrzeuge betrachtet. Die Ethik der Mensch-Maschine-Interaktion hingegen analysiert die Rückwirkungen, welche die Mediation menschlichen Handeln durch KI-gestützte Systeme auf unsere Moral hat. Im Vortrag werden hier als Beispiel medizinische Empfehlungssysteme und Large Language Models diskutiert.
Mittwoch, 2. Dezember 2026, 15.45 Uhr
Navigating the EU AI Act.
An Introduction to the European Regulation on Artificial Intelligence
Patrick Brunner
Research Associate, Intellectual Property Rights at FIZ Karlsruhe – Leibniz Institute for Information Infrastructure
The lecture focuses on the EU Artificial Intelligence Act, which came into effect on August 1, 2024. The main subjects of the regulation are AI systems and models, whose provision and use in the European Union are subject to specific obligations.
In particular, the lecture addresses the regulatory definition of AI systems and models, the risk-based classification of AI systems under the Act, and the obligations of providers and deployers of AI systems. It also discusses the establishment of a governance structure through the EU AI Act and the framework created by the AI Act to support innovation.
Finally, the lecture will examine the intersections between the AI Act and data- and digital-related legal frameworks.
The goal of the lecture is to provide the audience with an introduction to and overview of the EU AI Act and to raise their awareness of the subject matter.
Mittwoch, 9. Dezember 2026, 15.45 Uhr
Lösen „Privacy Enhancing Technologies“ den Widerspruch zwischen Datennutz und Datenschutz?
Leiter der KASTEL-Forschungsgruppe „Kryptographie und Sicherheit“, Sprecher und Initiator des Instituts für Informationssicherheit und Verlässlichkeit (KASTEL) und Direktor für Innovation, Strategie und Transfer am FZI
Der Umgang mit Daten birgt auch Risiken für die Privatsphäre. Im Vortrag werden sogenannte „Privacy Enhancing Technologies“ (PETs) vorgestellt, die ein wichtiges Werkzeug für den effektiven Umgang mit sensiblen Daten sein können. Dabei wird der Frage nachgegangen, ob PETs den Widerspruch zwischen der Nutzung von (sensiblen) Daten und den Anforderungen des Datenschutzes lösen können.
Mittwoch, 16. Dezember 2026, 15.45 Uhr, ONLINE über ZOOM
The People in People Analytics:
Potentiale und Risiken von algorithmischen Systemen in der Personalführung
Dr. Miriam Klöpper
Postdoktorandin in der Forschungsgruppe Wirtschaftsinformatik, Fakultät für Informationstechnik und Elektrotechnik an der Norwegian University of Science and Technology Trondheim (NTNU)
In weiten Teilen des Personalmanagements kommen immer häufiger sogenannte People-Analytics-Anwendungen zum Einsatz. Basierend auf algorithmischen Auswertungen sollen diese Anwendungen automatisiert beispielsweise Produktivität der Beschäftigten ermitteln, geeignete Teamzusammensetzungen und ungewollte Fluktuation prognostizieren oder auch Lebensläufe von Bewerberinnen und Bewerber auswerten. Dabei analysieren die Anwendungen sowohl historisch im Unternehmen gewachsene Datensätze, sammeln aber auch kontinuierlich von Arbeitnehmende ganz nebenbei generierte Daten, wie die Anzahl der gesendeten Emails oder geführten Telefonate bis hin zu Mausbewegungen oder Tastenanschlägen. Während Befürwortende der Systeme in diesen vor allem Neutralität und Fairness sehen, kommen einige Forschende zu dem Schluss, dass die Nachteile der Technologie die positiven Aspekte deutlich überwiegen. Im Vortrag werden die algorithmischen Systeme und die zugrundeliegenden Datensammlungen betrachtet und dabei deren Potentiale und Risiken erörtert.
Mittwoch, 13. Januar 2027, 15.45 Uhr
Informationssouveränität nach dem generativen Turn: KI-Kompetenzvermittlung an der KIT-Bibliothek
Kevin Schumacher M.A.
Leitung des AInformationLiteracy Lab der KIT-Bibliothek
Mittwoch, 20. Januar 2027, 15.45 Uhr
Datenintensives Rechnen und KI-Anwendungen ermöglichen
Dr. Jörg Meyer
Abteilungsleiter der Abteilung Data Analytics, Access and Applications (D3A), Scientific Computing Center (SCC), KIT
Big Data, Data Analytics, Künstliche Intelligenz und Cloud Computing bestimmen weiterhin viele Aspekte im heutigen Leben in Wissenschaft, Wirtschaft und Gesellschaft. Dieser Vortrag gibt einen Überblick über die Aktivitäten des Scientific Computing Center (SCC) des KIT in diesen Themenbereichen, welche die Generierung von Wissen aus Daten ermöglichen und unterstützen.
Mittwoch, 27. Januar 2027, 15.45 Uhr
Hydrology in the Digital Age: Machine Learning as a Key Technology for Flood Forecasting
Dr. Ralf Loritz
KIT-Junior Research Leader & KIT Associate Fellow, Institute for Water and Environment – Hydrology (IWU/HYD), KIT
The lecture will demonstrate how machine learning (ML) is transforming hydrology – and why these technologies have become a key tool for predicting floods, droughts, and other hydrological extremes.
Hydrology deals with the water cycle in all its facets – from precipitation to storage in the soil to runoff into rivers and lakes. Mathematical and physical models have been used for decades to understand these processes and predict future events. They represent the well-known laws of hydrology – such as infiltration, evaporation, and runoff formation – through equations, thereby enabling a quantitative description of water movement across the landscape.
But are new, data-driven approaches superior to these models? What are the respective advantages and disadvantages of each method? These questions are at the heart of the lecture.
Using examples from current research projects, such as the BMFTR-funded collaborative project KI-HopE, the talk will also demonstrate how current concepts are being implemented in practice – for instance, in the development of a Germany-wide, machine learning-based flood forecasting system in cooperation with the Deutscher Wetterdienst and the flood forecasting centers.
This presentation invites us to rethink hydrology as a data science discipline – how can an understanding of physics and artificial intelligence help us better identify the risks of flooding and drought and address them earlier?
Introduction to the KIT Graduate School Computational and Data Science | KCDS
Angela Hühnerfuß, M.A.
Managing Director, KIT Graduate School Computational and Data Science, KIT
The KIT Graduate School Computational and Data Science | KCDS at KIT Center MathSEE is an English-language graduate school for all doctoral researchers at KIT who are working on interdisciplinary, data- and model-driven research projects.
What sets KCDS apart is the tandem principle: Each doctoral candidate has one advisor from the mathematical sciences with a focus on methodology and one from the SEE discipline (natural sciences, economics, and engineering) with a focus on application. The interdisciplinary training program at KCDS offers doctoral candidates the opportunity to pursue targeted professional and interdisciplinary development, expand their network, and organize their own projects and events.
Mittwoch, 3. Februar 2027, 15.45 Uhr
Feminist Digitalization: Media, Memory, and Cultures of Care
Dr. Özge Çelikaslan
Media scholar, artist, researcher, and archivist, Germany
Digital technologies are often presented as neutral and progressive, yet their histories and infrastructures have long been shaped by patriarchal power relations. Moving from early computing in the twentieth century through the rise of the internet to today's AI, this lecture explores the contributions of women+ and feminist challenges to dominant narratives of technological progress. Phenomena such as the manosphere, online misogyny, and gender-based hate speech illustrate how digital cultures continue to reproduce inequalities. Yet the lecture draws on feminist media practices and initiatives that offer alternative approaches to knowledge production, collective memory, and participation. It considers their possibilities and limitations within an increasingly corporate digital landscape, asking how cultures of care might help us imagine more inclusive digital futures.
Mittwoch, 10. Februar 2027, 15.45 Uhr ONLINE über ZOOM
Energieverschwendung oder Hebel für den Wandel?
Künstliche Intelligenz im Nachhaltigkeitscheck
Künstliche Intelligenz verspricht effizientere Prozesse, intelligentere Mobilität und neue Lösungen für Klima- und Umweltschutz. Gleichzeitig benötigen leistungsfähige KI-Modelle enorme Rechenkapazitäten – mit wachsendem Strom-, Wasser- und Rohstoffverbrauch. Ist KI damit Teil des Nachhaltigkeitsproblems oder kann sie Teil der Lösung werden?
Der interaktive Vortrag nimmt KI kritisch unter die Lupe: Welche ökologischen und sozialen Kosten entstehen durch Rechenzentren, Trainingsprozesse, Hardware und globale Lieferketten? Und wo kann KI konkret helfen, Energie und Ressourcen zu sparen, Umweltveränderungen besser zu verstehen oder Klimaanpassung zu unterstützen?
Der Vortrag lädt dazu ein, KI weder pauschal als Klimaretterin noch als reine Energieverschwendung zu betrachten, sondern ihre Chancen, Grenzen und Voraussetzungen für einen verantwortungsvollen Einsatz kritisch zu diskutieren.
Mittwoch, 17. Februar 2027, 15.45 Uhr
Open Data – Zwischen Potenzial, Datenqualität und KI
Prof. Dr. Tobias Siebenlist
Professor für Informatik, insbesondere Datenbanken, an der Hochschule Düsseldorf
Alles offen, alles gut? Offene Daten versprechen Transparenz, neue Erkenntnisse und vielfältige Möglichkeiten zur Weiterverwendung. Doch wie offen und nutzbar sind öffentlich bereitgestellte Daten tatsächlich? Wo findet man sie, wie lässt sich ihre Qualität beurteilen – und was kann man am Ende mit ihnen anfangen?
Der Vortrag gibt einen Einblick in die Idee und Praxis von Open Data. Dabei geht es nicht nur um die Bereitstellung von Daten durch Verwaltungen, Wissenschaft und andere öffentliche Einrichtungen, sondern insbesondere um ihre tatsächliche Auffindbarkeit, Zugänglichkeit, Qualität und Nachnutzbarkeit. Open Government und verwandte „Open“-Ansätze wie Open Science, Open Access, Open Educational Resources und Open Source bilden dabei den größeren Kontext.
Neben etablierten Open-Data-Portalen und zivilgesellschaftlichen Initiativen wird auch betrachtet, wie sich große Datenangebote systematisch untersuchen lassen. Anhand aktueller Arbeiten zur automatisierten Analyse von Open-Data-Portalen und ihrer Metadaten wird gezeigt, welche Qualitätsprobleme in der Praxis auftreten und wie sich Datenbestände vergleichbar machen und bewerten lassen.
Schließlich stellt sich mit der zunehmenden Verbreitung künstlicher Intelligenz eine neue Frage: Welche Rolle können offene Daten für KI-Anwendungen spielen – und umgekehrt, wie können KI-Verfahren dabei helfen, offene Daten zu finden, zu erschließen und nutzbar zu machen?
Der Vortrag verbindet damit Grundlagen von Open Data mit Beispielen aus Forschung und Praxis und wirft einen kritischen Blick darauf, was zwischen dem bloßen Veröffentlichen von Daten und ihrer tatsächlichen Nutzung liegt.
Im Archiv finden Sie Informationen zu den Angeboten aus vergangenen Semestern.


 Interdisziplinäres Wissen zur Digitalisierung und eine grundlegende Informationskompetenz für die digitale Arbeitswelt, für maschinelles Lernen und für Anwendungen von Künstlicher Intelligenz sind sowohl im Alltag als auch im Studium und Berufsleben von großer Bedeutung.